株式会社 Navic クリエイト事業部
建設・再エネ機材レンタル企業のサイトと CMS を全面再構築
株式会社 Navic クリエイト事業部のサイトを再構築。Nuxt 4 の CMS と Astro 7 のフロントが 1 つの Cloudflare D1 を共有します。47,938 行、テスト 378 件、3.3 ヶ月の単独開発です。
概要
クライアントは株式会社 Navic のクリエイト事業部(navic-inc.jp)で、太陽光発電・蓄電池・保安機材のレンタルおよび販売を手がけています。旧サイトは Wix 上に構築されていたため、商品詳細ページはテンプレートの制約を受け、業務に合わせて自由に組み立てることができませんでした。
新サイトでは既存の CMS を一切使わず、Nuxt 4 と Astro 7 で管理画面とフロントをゼロから構築しました。商品詳細ページを組み立てる力を運用担当者に渡しつつ、訪問者側では静的サイトの速度を保つことが目標です。データベース設計からデプロイ設定まで、すべて一人で担当しました。
アーキテクチャ
2 つの Cloudflare Worker が同じ D1 データベース navic-rental を共有し、Nuxt 4 の CMS が書き込み、Astro 7 のフロントは読み取り専用です。メディアは R2 に置き、ブラウザは CMS が aws4fetch で発行した署名付き URL で直接アップロードし、Worker を経由しません。
公式の AWS SDK は workerd 上でモジュール読み込み時に loadConfig is not a function を投げます。依存チェーンがトップレベルで Node の fs を呼んでいるためです。aws4fetch に差し替えて解決し、調査結果は r2-presigner.ts のコメントに残しました。
フロントの 19 ページはビルド時にプリレンダリングし、実行時に動くのは API 3 エンドポイントだけです。セクションコンポーネントは Vue で JavaScript ゼロのレンダリング、絞り込み island は Solid で、コンパイル境界は astro.config.mjs の include のディレクトリ規約で分離しています。
技術的な難所
商品詳細ページのセクションビルダー
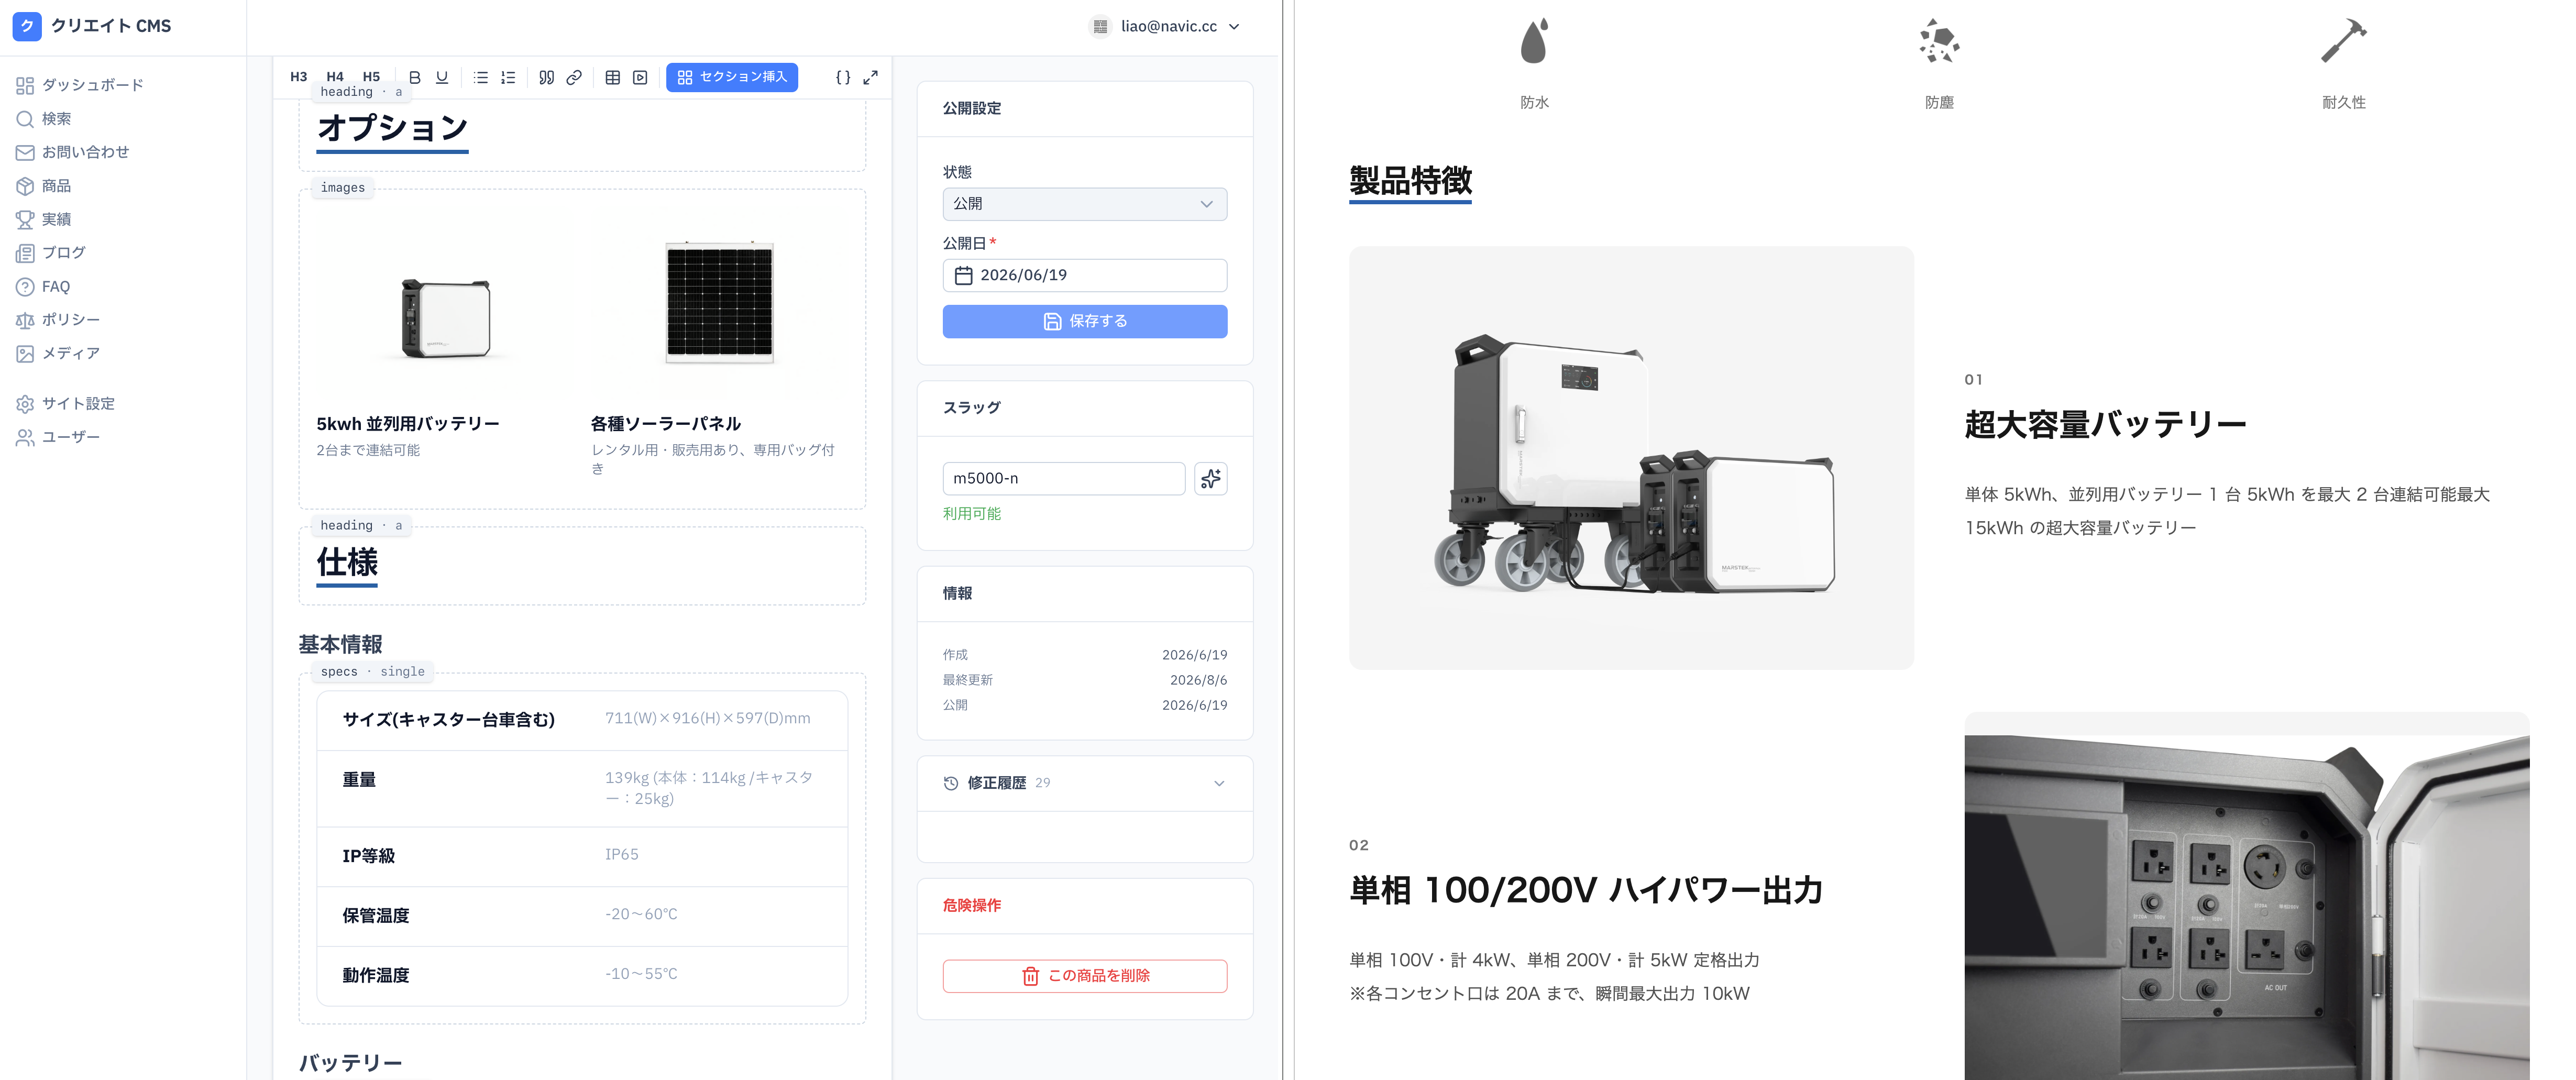
商品詳細ページでは、決められたビジュアル規定をそのまま再現する必要がありました。セクション 15 種類、バリエーション 41 個です。難しいのは数ではなく、エディタのフォーム・エディタのプレビュー・本番のレンダリングという 3 箇所がそれぞれ勝手にずれていくことでした。どれか 1 つのバリエーションにフィールドを足すたび、3 箇所すべてを直さなければなりません。
解決策は、セクションを独立した workspace パッケージ @repo/sections に切り出し、340 行の zod スキーマを唯一の契約にすることでした。管理画面のバリデーションとフロントのレンダリングが同じ型を読みます。27 個の Vue コンポーネントが CMS では tiptap の NodeView プレビューを、Astro では JavaScript ゼロのレンダリングを担当します。
データの形が異なるバリエーションは、フィールドをすべて任意にするのではなく discriminatedUnion で表現しています。こうすると入力漏れは保存時のバリデーションで弾かれ、訪問者がページを開いてから実行時エラーとして現れることがありません。
プリレンダリングと未公開の変更
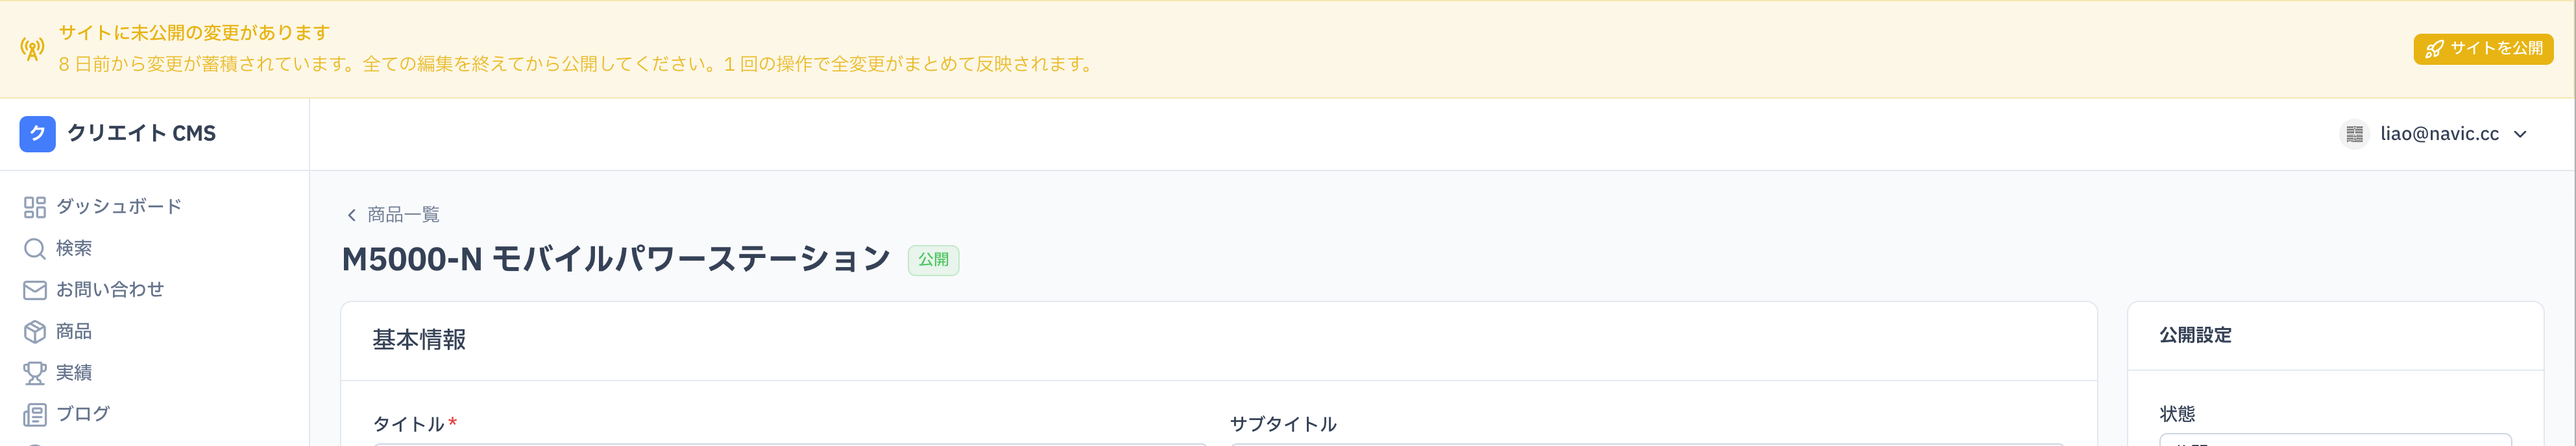
全ページのプリレンダリングには避けられない副作用があります。編集者が管理画面で内容を直しても、次のビルドが走るまでサイトは何も変わりません。一人で運用する現場では、コンソールへ手動でビルドを打ちに行くことを誰も覚えていられません。
解決策は、「未公開」をシステムの一級の状態として扱うことでした。書き込みパスの成功後に markBuildPending を呼び、単一行テーブル build_state を立てます。SQL は COALESCE(pending_since, ?) で最初の変更時刻を保持するため、バナーに滞留時間を表示できます。
公開ボタンは POST /api/build/trigger を叩き、サーバー側で WEB_DEPLOY_HOOK_URL を fetch します。シークレットを含む URL はブラウザへ一切渡しません。保存のたびに自動ビルドする方式は選びませんでした。10 個のフィールドを続けて直せばビルドが 10 回走るからで、人が確認したうえでまとめて公開する形にしています。
画像を消す前の全テーブル参照スキャン
media テーブルは 4 箇所から参照されますが、外部キーは featured_media_id と cover_media_id だけです。images_json・parts_json・gallery_json は素の id を、content_json は R2 のオブジェクトキーを持ち、いずれも制約では守られません。見落とせば画像が 404 になり、取り返しがつきません。
- 外部キー列は id をそのまま照合する
- 数値の配列は json_each で展開して 1 件ずつ突き合わせる
- オブジェクトの配列は json_extract でメディア id を取り出す
- 形の定まらない設定列は、JSON として妥当かを確かめてから展開する
- セクション本文はオブジェクトキーを保持しているため、エスケープ込みの部分一致に切り替える
- 該当があれば 409 を返して使用箇所を列挙し、どのコンテンツがその画像を使っているかを運用側に伝える
部分一致は厳密ではありませんが、意図的な取捨です。誤検知は取り消せる一度の拒否で済むのに対し、見落としは消えた R2 オブジェクトが戻らないことを意味します。以前の実装は data-media-id 属性を探していましたが、その属性はコードベースのどこにも書かれたことがなく、スキャンは一度、静かに機能しなくなっていました。
これらの参照を中間テーブルへ正規化する道は選びませんでした。教科書的にはそれが正解です。ただし正規化すると、コンテンツを保存するたびに delete と insert の同期処理が付いて回ります。メディアの削除は頻度の低い操作なので、一度の全件スキャンで長期的な同期の負担を買い取るほうが割に合います。
公開サイト